McKinseyによる企業の人工知能(AI)導入調査によると、生成AIを実際の業務に本格展開できている企業は全体のわずか11%にすぎません。多くの企業が依然として実証実験(PoC)の段階や、限定的な活用にとどまっています。ボトルネックは、AIモデル自体の性能ではありません。AIモデルを実際の業務プロセスに結びつけるための「アーキテクチャ」にあります。
これはARUOが解決する課題です。技術的な問題というよりも、システムの設計思想(アーキテクチャ)の問題と言えます。
デモは常に成功する。本番環境で崩壊する理由
AIの実証実験(デモ)は、基本的にうまくいきます。あらかじめ用意されたプロンプトを入力し、それらしい回答が出力されるからです。デモの段階では、AIが自社の製品カタログを把握しているか、社内文書にアクセスできるか、あるいは価格の例外処理を理解しているかといった点は検証されません。
しかし、本番環境への移行時にはこうした現実的な問いが一気に噴出します。その解決に必要なのは、より良いプロンプトの作成ではなく、システム基盤(インフラ)の構築です。
大規模言語モデル(LLM)は、インターネット上の膨大な公開情報に基づいて学習されています。一般的な知識は豊富ですが、自社の社内規定や顧客データ、業務ルールといった個別のビジネス事情は一切知りません。これは、ネット上のすべての情報を読み込んではいるものの、自社のオフィスに入ったこともなく、社内業務を全く理解していない、非常に優秀な新入社員を雇うようなものです。
この知識のギャップをどう埋めるかが、企業のAIプロジェクトが成功するか、あるいは頓挫するかの分かれ道になります。
多くの組織が見落とす3つの連携レイヤー
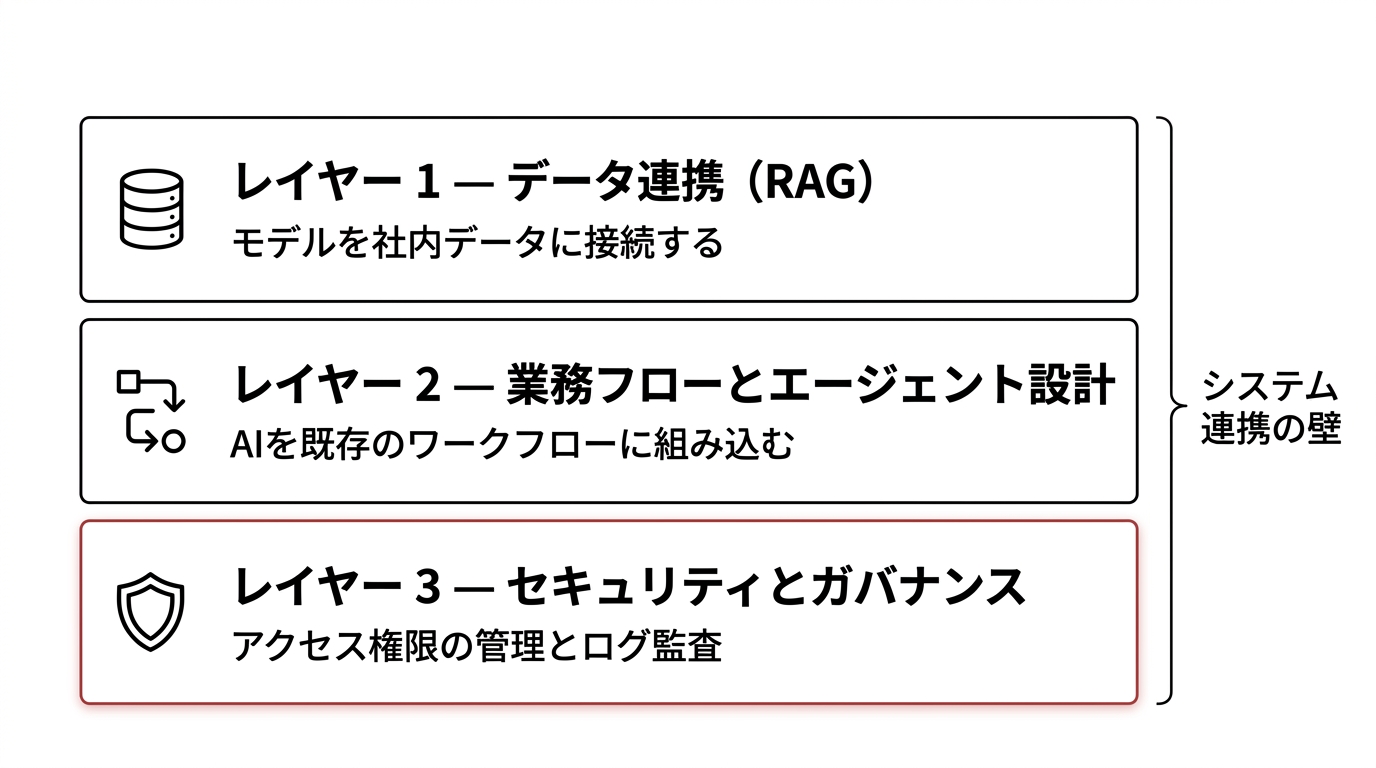
ARUOでは、さまざまな業界で共通する導入失敗のパターンを見てきました。多くの組織は、AIモデルの選定やユーザーインターフェースの開発に注力しますが、実際の実装プロセスの大半を占める「3つのレイヤー」の開発を後回しにしてしまいます。
レイヤー1:データアクセスと検索
自社の内部データにアクセスできないLLMは、一般的な回答を返すか、事実無根のそれらしい誤回答を出力します。これはAI分野で「ハルシネーション(幻覚)」と呼ばれる現象であり、根拠のない情報を自信たっぷりに提示してしまう状態を指します。
この課題に対する構造的な解決策が、検索拡張生成(RAG:retrieval-augmented generation)と呼ばれる設計手法です。RAGは、ユーザーが質問を入力した瞬間に、モデルを社内の情報源に接続します。モデルは学習データだけに頼るのではなく、まず社内システムから関連文書を検索し、その情報に基づいて回答を出力します。
プロンプトの調整だけでデータアクセス不足を補うことはできません。AIモデルが在庫データベースや過去の顧客対応履歴、社内手順書を参照できなければ、いくら質問の文言を工夫しても正しい回答は得られません。まず検索・抽出の仕組みを作る必要があります。私たちが関わるプロジェクトの多くでも、この連携部分が当初の計画から漏れているか、設計が不十分なケースがほとんどです。
レイヤー2:業務フローの統合とエージェント設計
チャット画面は単なる道具にすぎません。しかし、実際の業務プロセスは複数のステップが連なる「フロー」で構成されています。例えば、顧客からの問い合わせに対して内容を分類し、データベースを参照して返信案を作成し、担当者の最終確認を経て送信する、といった流れです。
AIを単なるチャットツールから、業務フローの自律的な参加者へと変えるのが「エージェント設計」です。エージェントは、届いたメッセージを読み取り、次に取るべき行動を判断して社内システムへ問い合わせを行い、返信のドラフトを作成した上で、担当者へ確認を求めるところまでを自動化します。
多くの企業はこの開発期間を甘く見積もりがちです。私たちの経験上、プロジェクトチームは最初の2週間をAIモデルの選定に使い、その後の3ヶ月を既存システムとの連携に費やすことになります。AIモデルそのものよりも、適切なエラー対策を含めたシステム構築にこそ、大半の手間がかかります。
レイヤー3:セキュリティとデータガバナンス
顧客データや従業員情報、機密性の高い研究データに対してAIを適用する場合、実証実験の段階では見過ごされがちなリスクが生じます。AIはどのデータにアクセスしているのか、データは外部ベンダーへ送信されるのか、出力ログは適切に記録されているか、また、AIが顧客対応で誤った回答を出した際の責任は誰が負うのか、といった論点です。
これらは避けて通れない問題です。法務やコンプライアンス、情報セキュリティの担当部署は、本番環境への導入前に必ずこれらの点を厳しくチェックします。セキュリティの設計思想を後回しにすると、リリース直前のセキュリティ審査で不合格となり、システムの大半をゼロから作り直す事態に陥ります。
最初からセキュリティを組み込んで設計する方が、結果的に手戻りを防ぎ、プロジェクト全体の開発スピードを向上させます。
人による承認(HITL)から人による監視(HOTL)へ
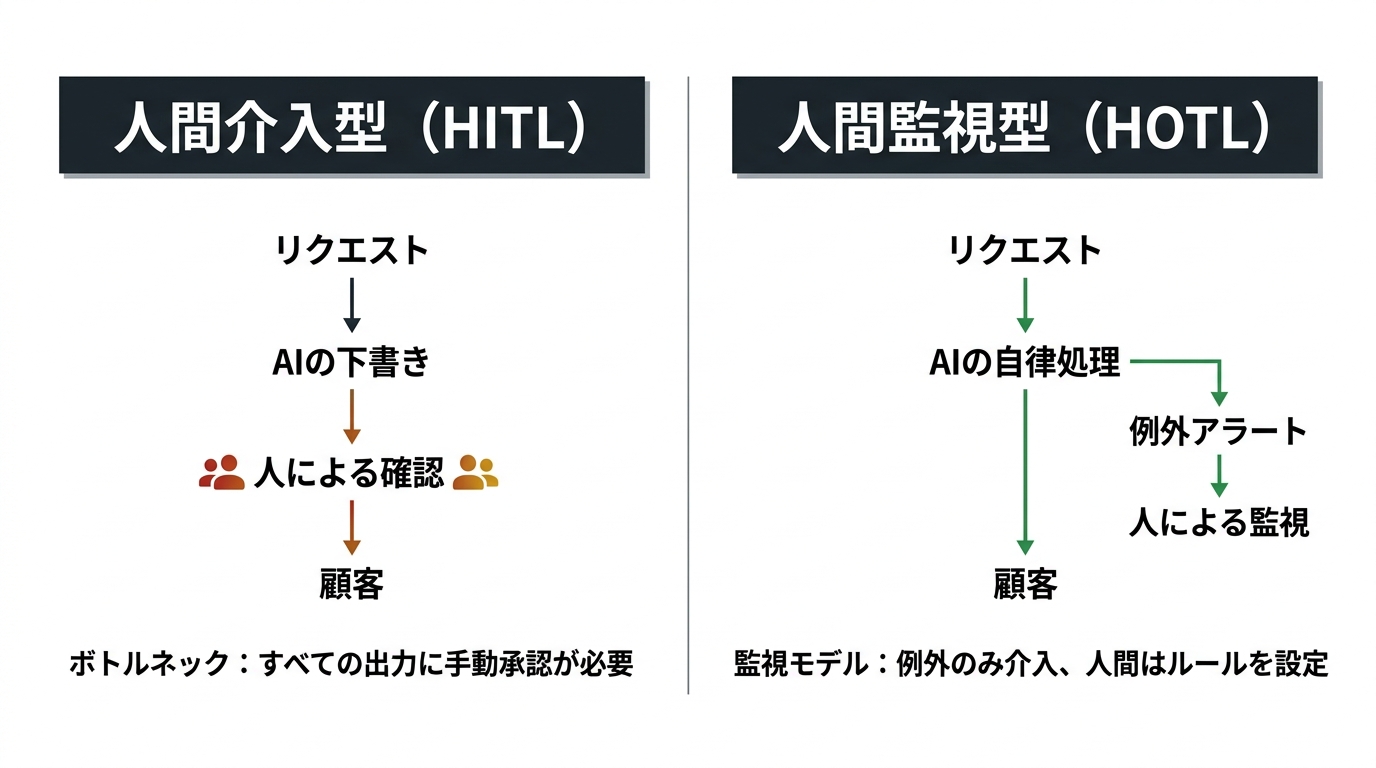
初期のAI活用では、AIが出力したすべての回答を人間が確認する「人間介入型(HITL:human-in-the-loop)」が一般的でした。この方法は安全ですが、業務のボトルネックになります。すべての返信案に手動の確認が必要であれば、AIがもたらすはずの時間短縮効果はほとんど失われてしまいます。
これに対し、本格的にAIを運用している企業では、AIが定型的な業務を自律的に処理し、人間は全体を監視する「人間監視型(HOTL:human-on-the-loop)」を採用しています。人間はすべてのやり取りに直接関与するのではなく、AIが判断基準から外れた場合や、あらかじめ設定した例外ルールに抵触した際にのみ介入します。
この移行は、想像以上に事前の設計が必要です。どのような状況を「通常稼働」とするか、どの段階で人間にエスカレーション(通知)するか、またAIが対応できない状況に陥った際の代替プロセスをあらかじめ定義しなければなりません。このルール設計を怠ると、現場がシステムを信頼できず、結局使われなくなってしまいます。
システム構築の具体的なステップ
「AI連携」というと、アプリケーション・プログラミング・インターフェース(API:application programming interface)のキー設定やソフトウェアのインストールといった、単純な接続作業をイメージされるかもしれません。しかし、本番環境で稼働させるための実際の構築ステップは以下のような設計を伴います。
- AIモデルが必要とする社内データソースの確認と、検索に適したデータ構造の整理
- モデルが必要な情報のみを参照し、機密データにアクセスしないためのRAG検索制御の構築
- どのステップをAIに自律処理させ、どの部分を人間の確認必須とするか、業務フローの再設計
- どのデータへアクセスしたかをすべて追跡可能にするセキュリティログの構築
- 本番運用前に、例外処理やエッジケースに対応できるかを検証するテストの実施
これらはすべてシステム統合(SI:systems integration)の仕事です。LLMの挙動とエンタープライズIT環境の管理ルールの双方を深く理解しているエンジニアがいなければ、システムとして成り立ちません。AIモデルを提供するベンダーは「機能」を渡すだけですが、ARUOはそれを実用的なシステムへと仕立て上げます。
本格導入に向けた現状の整理
多くの企業と議論を重ねる中で、導入の障壁は主に次の3つのステージに分類されます。
- デモ画面での検証を終え、実用的なユースケースを探している段階。
- ユースケースは決まったものの、データ連携やセキュリティの壁に突き当たっている段階。
- 特定の業務で運用を開始したものの、他業務へ展開するためにアーキテクチャの再設計が必要な段階。
それぞれの状況によって、次にとるべきアクションは異なりますが、共通しているのは「AIモデルの性能そのものが課題になっているわけではない」という点です。
ARUOは、組織の現在の状況を分析し、データ検索レイヤーの構築、エージェントワークフローの設計、セキュリティのセットアップ、および人間による監視ルールの作成まで、本番運用に必要な全体アーキテクチャを設計します。デモの成功にとどまらず、現場が信頼して使い続けられるシステムを構築します。
自社のAI導入における次のステップについては、ARUO(hello@aruo.tech)までお気軽にお問い合わせください。