あなたの会社で、全社員が生成AIツールを使えるようになりました。「これで毎週何時間もの業務を削減できる」と上司は言います。さっそくチャット画面を開き、最初の質問を入力してみます。数秒で返ってきた回答は、とても説得力がありそうに見えましたが、実は間違っていました。
この「正しそうに見えること」と「実際に正しいこと」のギャップこそが、本ガイドが解き明かそうとしているテーマです。
これは技術的な解説書ではありません。生成AIがどのような仕組みで動いているかを理解しなくても、使いこなすことは可能です。しかし、ベンダーのデモでは教えてくれない3つの重要なポイント(AIに明確な指示を与える方法、AIのでっち上げを見抜く方法、そしてどの情報を絶対に入力してはいけないか)を理解する必要があります。
セントラルキッチン:AIが実際にやっていること
コンピューターサイエンスの難しい話を使わずに、生成AIモデルの動きを最もわかりやすく説明する方法がこちらです。
何億ものレシピやメニュー、食材の組み合わせを処理してきた「セントラルキッチン」を想像してみてください。あなたが注文(指示)を出すとき、このキッチンは特定のレシピを検索しているわけではありません。本棚から本を取り出して調べているのでもありません。これまで見てきたすべての調理パターンに基づき、あなたが求めているものに「最も近いと思われる料理」をその場で新しく作っているのです。
これが、検索エンジンとの最大の違いです。検索エンジンは「すでに存在する文書」を探し出します。一方、生成AIは「新しいアウトプット」を作り出します。データベースから答えを引っ張ってくるのではなく、学習したパターンからその場で料理をしているのです。
この違いが、AIの強みとリスクの両方を説明してくれます。強みは、状況に合わせてオリジナルで適切なアウトプットを作れることです。リスクは、間違ったパターンに基づいて作られたものであっても、完成された本物そっくりの見栄えで出力されてしまうことです。
検索エンジンであれば、情報源となるリンクが表示されるので追跡できます。しかし生成AIは、出典を示さずに100%の自信に満ちた回答を出力します。見た目だけでは、正しい料理なのか、それとも説得力のある失敗作なのかを区別することはできません。
キッチンが料理を間違えるとき
ハルシネーション(幻覚):自信満々の間違いと、あなたの責任
生成AIについて最も知っておくべき事実はこれです。「AIは完全に捏造された情報を、さも真実であるかのように確信を持って出力することがある」ということです。
これはハルシネーション(幻覚)と呼ばれます。AIは嘘をついているわけではありません。自分が間違っていることすら知らないのです。入力されたプロンプトに対して、統計的に最も自然につながる言葉を生成しているだけで、その内容がたまたま事実と異なっていたに過ぎません。
具体的には、以下のような問題が発生します。
- 契約書の要約で、重要な条項の意味が真逆になってしまう
- クライアント向けの資料に、存在しない報告書が引用される
- 法令チェックリストで、AIの学習データ以降に導入された新しい規制が抜け落ちてしまう
- 製品仕様書に、もっともらしいが間違った数値が入り込む
これらはどれも、一見するときれいに書かれており、AI自身がエラーを知らせることもありません。
ルールは極めてシンプルです。AIが出力したものはすべて「たたき台(初稿)」に過ぎません。あなたが最終的な編集者であり、内容の正確さに全責任を負います。 もしAIが作成したドキュメントに間違いがあり、それがそのまま送信された場合、責任はツールではなく、確認せずに送った本人にあります。これは形式的なルールではありません。コンプライアンスが求められるすべてのビジネスにおける現実です。
AIが作ったアウトプットを顧客や上司に送る前、または公式なファイルに保存する前には、必ず事実確認(ファクトチェック)を行ってください。特に数値、引用元、法的な参照、期限のある情報については入念な確認が必要です。
明確な注文を出す:プロンプトフレームワーク
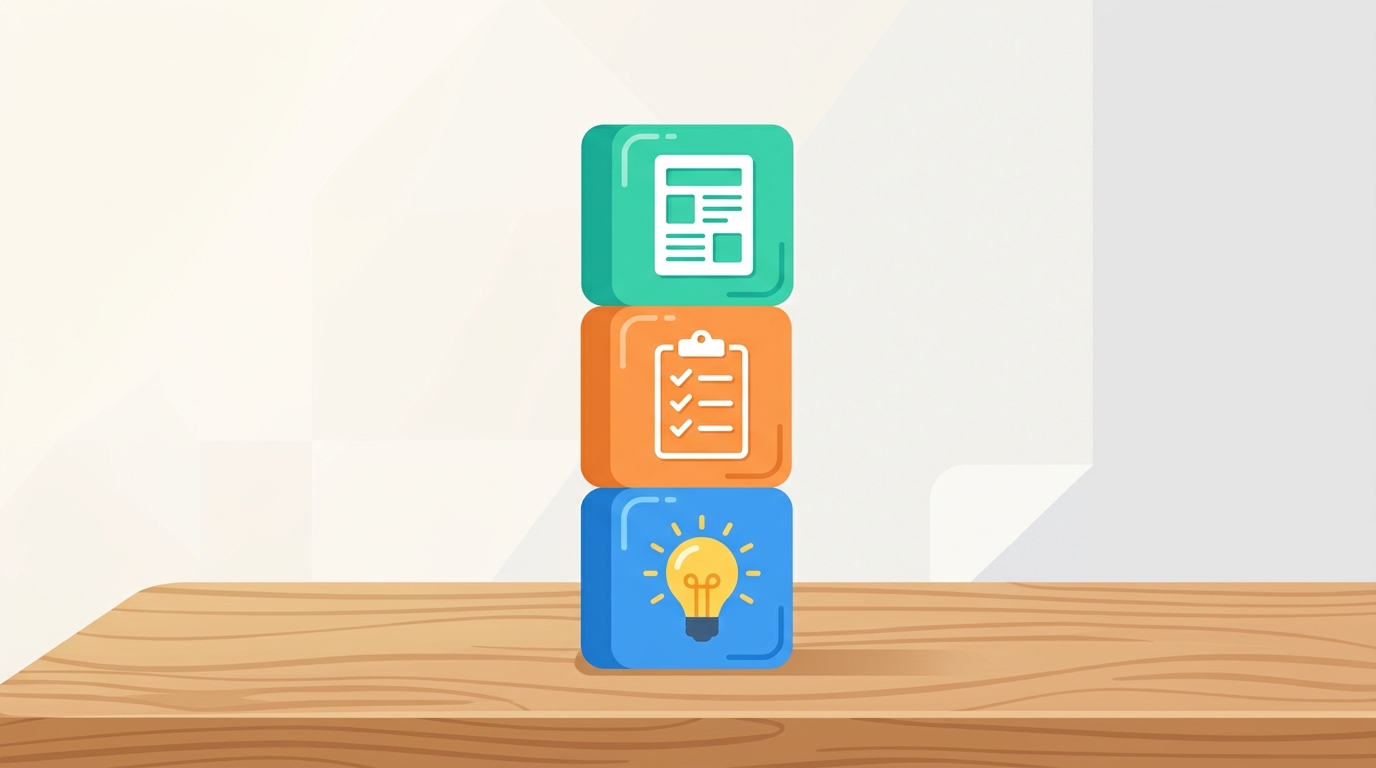
AIのアウトプットの質を左右する最大の要因は、あなたが与える指示(プロンプト)の質です。曖昧な注文からは、曖昧な料理しか生まれません。「ゴミを入力すれば、ゴミが返ってくる(Garbage In, Garbage Out)」のです。
多くの人が、検索エンジンを使う感覚でAIにキーワードを入力してしまいます。しかし、これでは平均的な回答しか得られません。明確な構造を持ったプロンプトを書くことで、常に質の高い回答を得られるようになります。
業務でAIを使う際は、以下のフレームワークを必ず使ってください。
背景(Background): AIが見ることのできない文脈を与えます。対象読者は誰か?どのような状況か?このアウトプットを使ってどのような意思決定を行うのか?
任務(Task): やってほしいことを具体的に指示します。「〜について書いて」ではなく、「Xについて、Y向けに、Zに焦点を当てて、わかりやすい言葉で200文字で要約して」と伝えます。
出力形式(Output format): 結果の見た目を指定します。箇条書きにするのか、3段落のメール形式にするのか、2列の表にするのか、丁寧なビジネス日本語にするのかを指定します。
フレームワークを使う前のプロンプト:
「クライアント向けに、当社のサービスについて要約して」
これではAIは、どのサービスか、どのくらいの詳細さか、クライアントが何を求めているのかをすべて推測しなければなりません。結果として、どこにでもある退屈な文章が返ってきます。
フレームワークを使った後のプロンプト:
「背景:AIツールを導入したことがない中堅の物流企業に提案を行います。相手は投資対効果(ROI:Return on Investment)に懐疑的で、導入コストを懸念しています。任務:ARUOのAI導入支援サービスによって、手入力のデータ処理業務がどのように削減されるかを、専門用語を使わずに150文字程度で要約してください。出力形式:短い3つの段落。専門用語はなし。箇条書きは使わないでください。」
この指示があれば、AIは的外れな回答を避けることができます。もちろん後から人間のチェックは必要ですが、求める成果物に格段に近づきます。
指示を具体的に書くことは、後からの手戻りを減らすことにつながります。プロンプト作成にかける少しの時間は、その後の編集時間を大きく節約してくれます。
公開AIツールに入れてはいけないデータ
このセクションは、会社で業務を行う上で必須のコンプライアンスルールです。
一般的な公開AIツールでは、入力データが社外のサーバーに送信されます。ツールや契約条件によっては、サービス改善やモデル学習に利用される場合があります。そのため、入力前に各ツールの利用条件と社内ルールを必ず確認してください。
以下のカテゴリに該当する情報は、いかなる場合も公開AIツールに入力してはいけません。
顧客およびクライアントの個人情報
氏名、連絡先、アカウント番号、取引履歴、個人識別番号(パスポートや納税者番号など)、またはクライアントから秘密保持の条件で預かっている情報。
非公開の財務情報
未公開の売上数値、予算計画、価格戦略、契約条件、業績予測など。これらを公開モデルに入力することは、秘密保持義務の違反となるだけでなく、インサイダー取引規制などの法的リスクを生む可能性があります。
製品のソースコードやシステム設計書
開発中のシステムや自社製品のソースコード、内部アプリケーションプログラミングインターフェース(API:Application Programming Interface)の構造、システムのネットワーク構成図など、秘密保持契約(NDA:Non-Disclosure Agreement)で保護されるべき技術情報。
人事・労務関連の情報
従業員の評価記録、給与データ、懲戒記録など、雇用契約や法令によって厳格な管理が求められる人事情報。
係争中の法的問題に関する情報
訴訟や規制当局からの調査、契約上の紛争に関する事実関係、社内相談、弁護士とのやり取りなど。
判断に迷ったら、自分にこう問いかけてみてください。「この入力内容が、明日の新聞の一面や、競合他社の画面に表示されても問題ないか?」もし答えが「ノー」であれば、絶対に入力してはいけません。
もし会社が公式に契約し、データが二次利用されないセキュリティが担保された専用のAI環境を用意している場合は、ルールが異なる場合があります。どのデータがどのツールに許可されているかについては、情報技術(IT:Information Technology)部門やコンプライアンス担当者に確認してください。
あなたの役割:シェフであって、アシスタントではない
「AIに仕事が奪われるのではないか」という懸念は、真剣に向き合うべきテーマです。しかし、その捉え方は少し違っています。
変わるのは「人間が関わるかどうか」ではなく、「プロセスのどこに関わるか」です。
初期のAI活用では、人間がすべてのプロセスに関与する「ヒューマン・イン・ザ・ループ(HITL:Human-in-the-Loop)」モデルが取られていました。AIが出力したすべての結果を、人間が1つずつチェックして進める方法です。これは安全ですが、確認作業のボトルネックが発生し、AIがもたらすはずの時間短縮効果が失われてしまいます。
そこで、現在の実用的な活用では「ヒューマン・オン・ザ・ループ(HOTL:Human-on-the-Loop)」モデルが主流になっています。このアプローチでは、AIが日常的なドラフト作成やデータの整理を自律的に行います。人間はプロセスの中に張り付くのではなく、一歩引いた「監視・指揮」のポジション(ループの上)に立ちます。基準を設定し、成果物をスポットチェックし、重大なリスクがある場面で介入します。
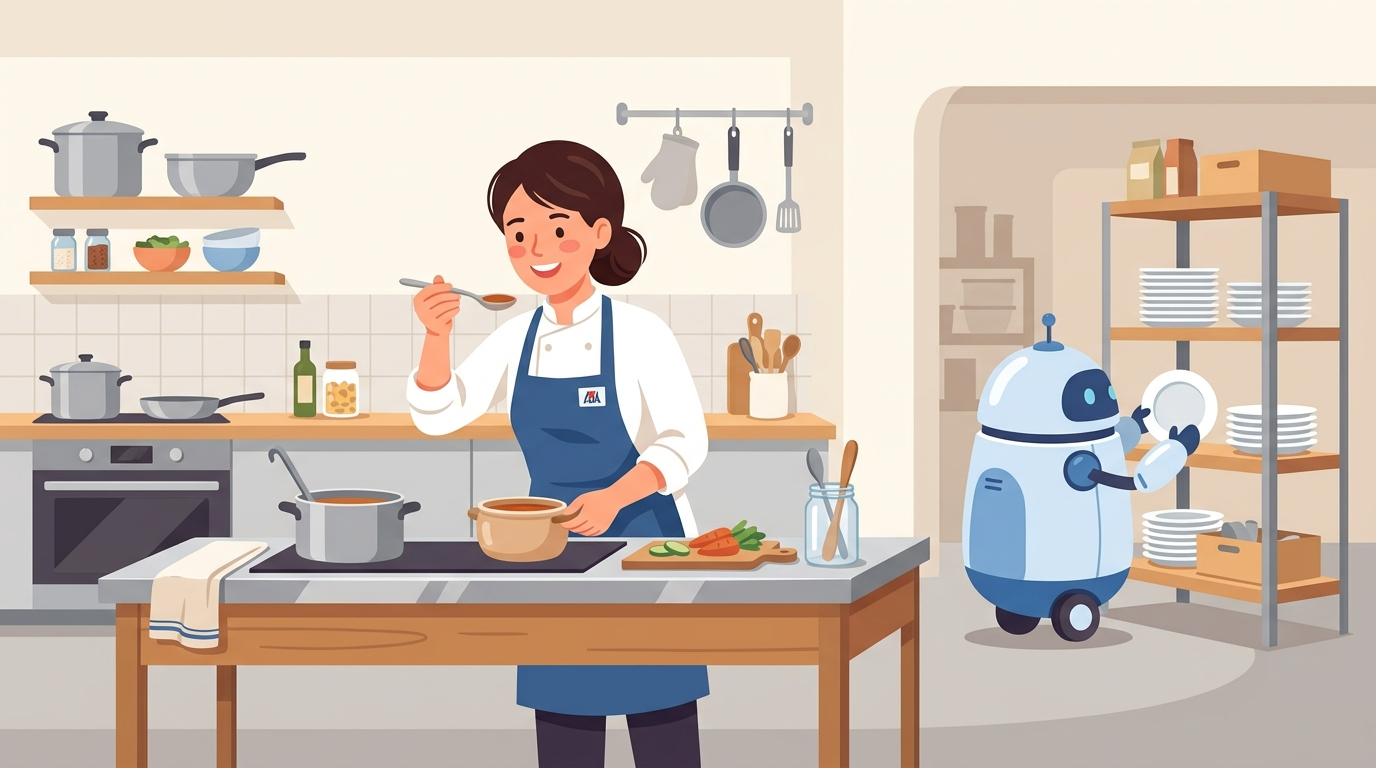
キッチンの例をもう一度思い出してみましょう。総料理長(シェフ)は、すべての野菜を自分で刻むわけではありません。メニューを考案し、キッチンの基準を決め、スタッフを育成します。調理中、シェフはキッチン全体を見渡し、仕上がりをスポットチェックし、スープの味見をし、VIP向けの料理や初めて提供するメニューなど「失敗が許されない重要な料理」だけを自ら仕上げます。すべての皿の前に立ち塞がるのではなく、適切なタイミングで適切に介入するのです。
これが、あなたの新しい役割です。あなたはAIに置き換えられるアシスタントではありません。チームを率いるシェフなのです。
この役割には、自分で手を動かすのとは異なる「編集者としての視点」が求められます。「何が正しく書かれているか」ではなく、「何が欠けているか」「何が間違っているか」を見抜く目です。「この数値は正しいか?」「このデータは最新のものか?」「この文章のニュアンスは取引先に適しているか?」という確認の習慣こそが、AIを道具として使いこなすチームと、AIの自信満々な間違いに振り回されるチームを分けます。
AIを使って作成したコンテンツを送る前のセルフチェック
- 「背景」「任務」「出力形式」を意識したプロンプトを書きましたか?
- 出力された数値、統計、引用元について、自分で事実確認を行いましたか?
- プロンプトからクライアント名や個人情報、未公開の数値を削除しましたか?
- 使用したツールは、自社が承認した環境ですか?それとも公開ツールですか?
- AIが作成を支援したことを含め、この資料に自信を持って自分の名前を載せられますか?
これらすべてのチェックに「はい」と答えられるなら、あなたはAIを最も効果的に協働パートナーとして活用できています。
ツールが承認されているか、または機密データの取り扱いについて質問がある場合は、IT部門またはコンプライアンスチームにお問い合わせください。社内のAI活用ガイドラインの最新情報については、社内ポータルを参照してください。