不確実性を口にしない、記憶力抜群のインターン
入社したばかりのインターンを想像してみてください。そのインターンは、社内のあらゆるマニュアルや過去のプロジェクト資料、会議の議事録をすべて読み込んでおり、驚異的な記憶力を持っています。何か質問をすれば、完璧な文章で、自信たっぷりに即座に答えてくれます。
しかし、困ったことに、そのインターンは知識の隙間を「もっともらしい創作」で埋める癖があります。正確な数字が見つからないときは、それらしい数字を自分で作ってしまいます。2つの異なるプロジェクトの記憶が混ざって、一つの物語としてスムーズにつなぎ合わせてしまうこともあります。悪意があって嘘をついているわけではありません。本人は自分の言っていることを正しいと信じ込んでおり、ただ「社長の役に立ちたい」という一心で答えています。
これこそが、AIのハルシネーション(幻覚)を最も正確に表す比喩です。AIは、質問に対して「最も確率的にそれらしい返答」を生成するように作られており、その内容が真実であるかどうかは考慮していません。
スタンフォード大学のRegLab(規制・評価・ガバナンス研究所)とHAI(人間中心AI研究所)による共同研究では、特定の専門的な法務AIアシスタントであっても検証クエリに対して約17%から33%の割合でハルシネーションを起こすことが確認されており、一般的な対話型AIはさらに高い頻度で誤情報を出力することが指摘されています。契約書の要約や競合分析、財務データの整理などをAIに頼っている企業にとって、このエラー率は無視できないコストとなります。事実と異なる法律の条文、架空の製品仕様、誤った市場データを役員会用の資料に載せてしまうリスクは、決して絵空事ではありません。
AIが自信満々に嘘をつく仕組み
ハルシネーションが起きる原因を理解することは、エンジニアだけの仕事ではありません。実務で正しい防衛策を立てるための必須知識です。
大規模言語モデル(LLM)は、検索エンジンのようにデータベースから直接事実を引っ張ってきているわけではありません。彼らがやっているのは、学習したパターンに基づいて「前にある単語の次に続く確率が最も高い単語」を順番に予測して並べる作業です。モデルの内部には、参照した元のドキュメントへのリンクもなければ、「私はこの情報を知らない」と判断するフラグも存在しません。あるのは、次に続く言葉の確率分布だけです。
そのため、学習データにないことや、矛盾する複数のソースから曖昧に学習したことについて質問されても、AIは途中で止まることができません。そのまま文章を書き続けます。出力された文章が非常に流暢で自信に満ちて見えるのは、そのような書き方こそが学習プロセス(事前学習や微調整)で最も高く評価されるからです。
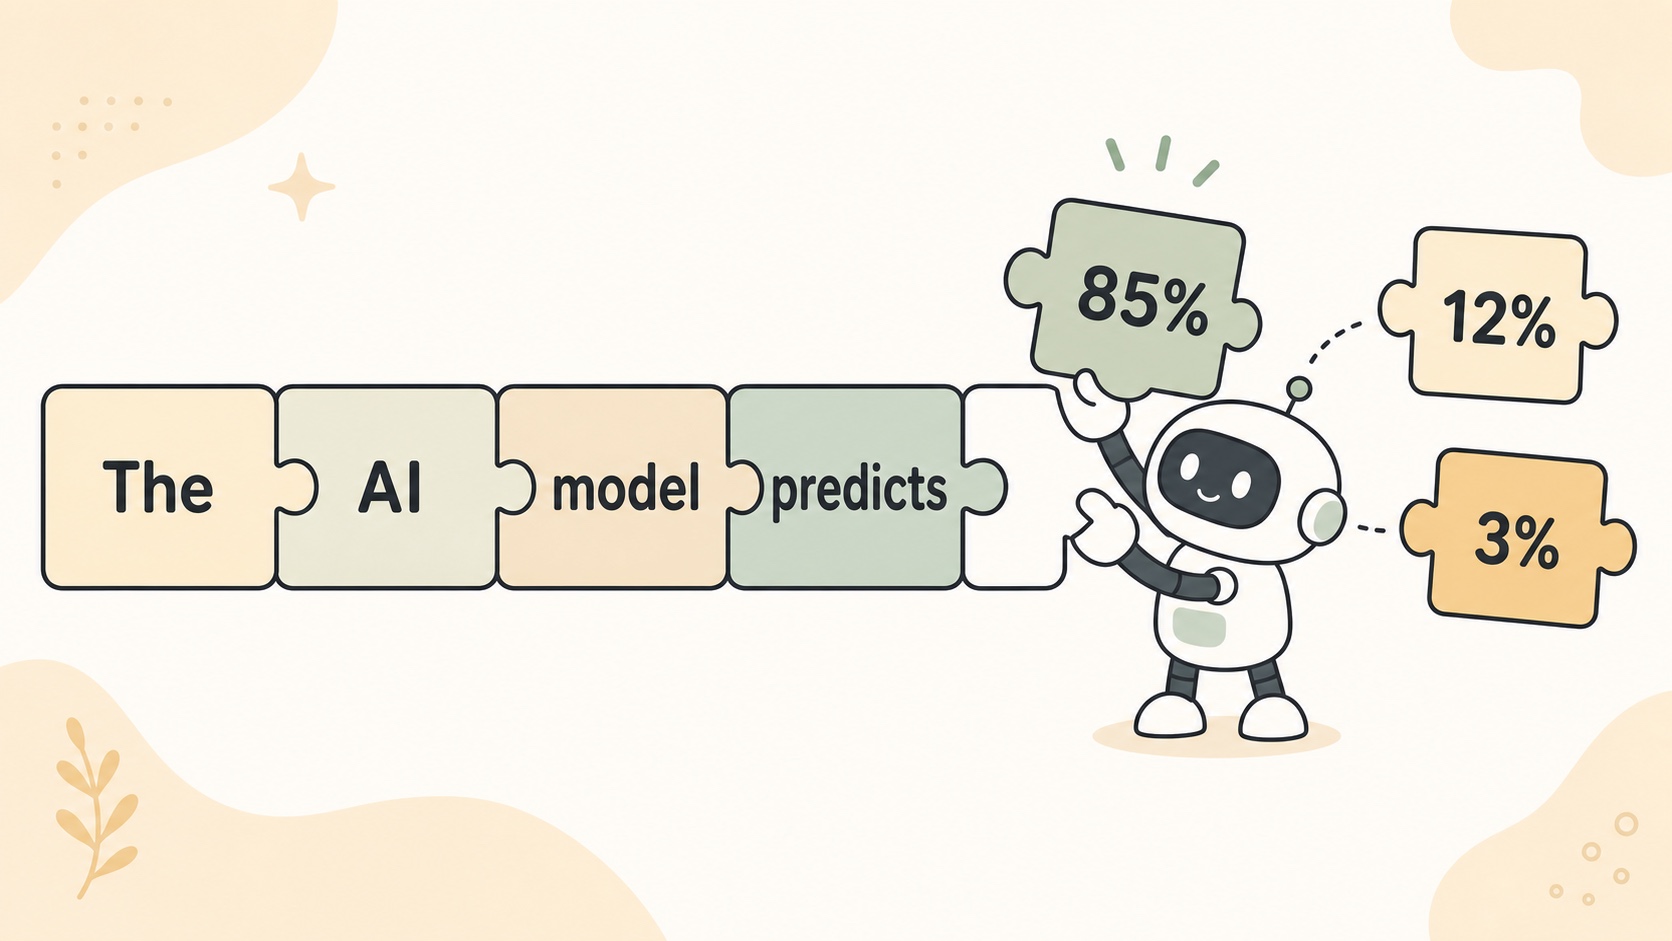
この仕組みは、ビジネス実務においていくつかの明確なリスクをもたらします。
- AIは、全く知らないことよりも「中途半端に知っていること」について質問されたときが最も危険です。全く知らなければ分かりやすい間違いをしますが、中途半端な知識は極めて巧妙な間違いを生み出します。
- 出力された文章の自信(トーン)と、その正確さには何の因果関係もありません。ハルシネーションによる嘘の回答も、正しい回答と全く同じトーンで出力されます。
- 複数ステップの論理思考を必要とするタスクでは、初期段階で発生した小さなハルシネーションが次の推論の前提となり、最終的に「論理的につじつまは合っているが、前提がすべて間違っている回答」が出来上がります。
なぜプロンプトの工夫だけでは防げないのか
ハルシネーションについて知った企業が最初に行うのは、プロンプトの改善です。「もっと正確に答えてください」「根拠のないことは言わないでください」といった指示を追加しようとします。
このアプローチは直感的ですが、根本的な解決にはなりません。
プロンプトは、モデルが持っている知識を出力する際の「振る舞い」をコントロールするだけであり、モデルが学習していないデータや、手元にない事実を後から追加することはできないからです。プロンプトで「正確に」と指示しても、表現方法が変わるだけで、知識の欠如そのものは埋まりません。
例えば、先月締結したばかりの社外秘の契約書についてAIに要約を求めたとします。その契約書は当然モデルの学習データには存在しません。プロンプトをどれほど工夫しても、AIは回答を拒否するか(こちらの方が安全です)、見たこともない契約書の内容をもっともらしく捏造して要約を作り出すかのどちらかになります。
プロンプトだけでは解決できない構造的な理由は3つあります。
- モデルは、社内の最新データや非公開データに直接アクセスできません。
- モデルは、自分が学習した内容が正しい事実なのか、低品質なWebサイトから拾ったデタラメなのかを区別できません。
- モデルには、自分の回答の不確実性を正確に測定して伝える仕組みがありません。
アーキテクチャによる解決:自社データへの紐付け
ハルシネーションの根本的な解決には、プロンプトの調整ではなく、システムの設計(アーキテクチャ)そのものを変える必要があります。
現在、企業の現場で最も信頼されている設計が「RAG(Retrieval-Augmented Generation:検索拡張生成)」です。RAGは、AIに文章を作らせるステップの前に、まず社内の信頼できるデータベースから関連する検証済みドキュメントを検索して引っ張ってくるステップを挟みます。アンド、AIには「この持ってきたドキュメントの中に書いてあることだけで回答を作ってください」と命令します。モデル自身の記憶ではなく、提供された資料に基づいて回答させるアプローチです。
このアプローチにより、実務におけるAIの挙動は劇的に改善します。
- AIの出力が、企業自身がコントロールし検証できるソースドキュメントに直接紐付けられます。
- エラーの検証が可能になります。誤った回答が出た場合、どのドキュメントの記述が原因だったのかを遡って特定できます。
- 出力にソースへの参照(引用元)を明記させることができるため、人間の担当者がインターンのレポートを確認するのと同じ感覚で検証できます。
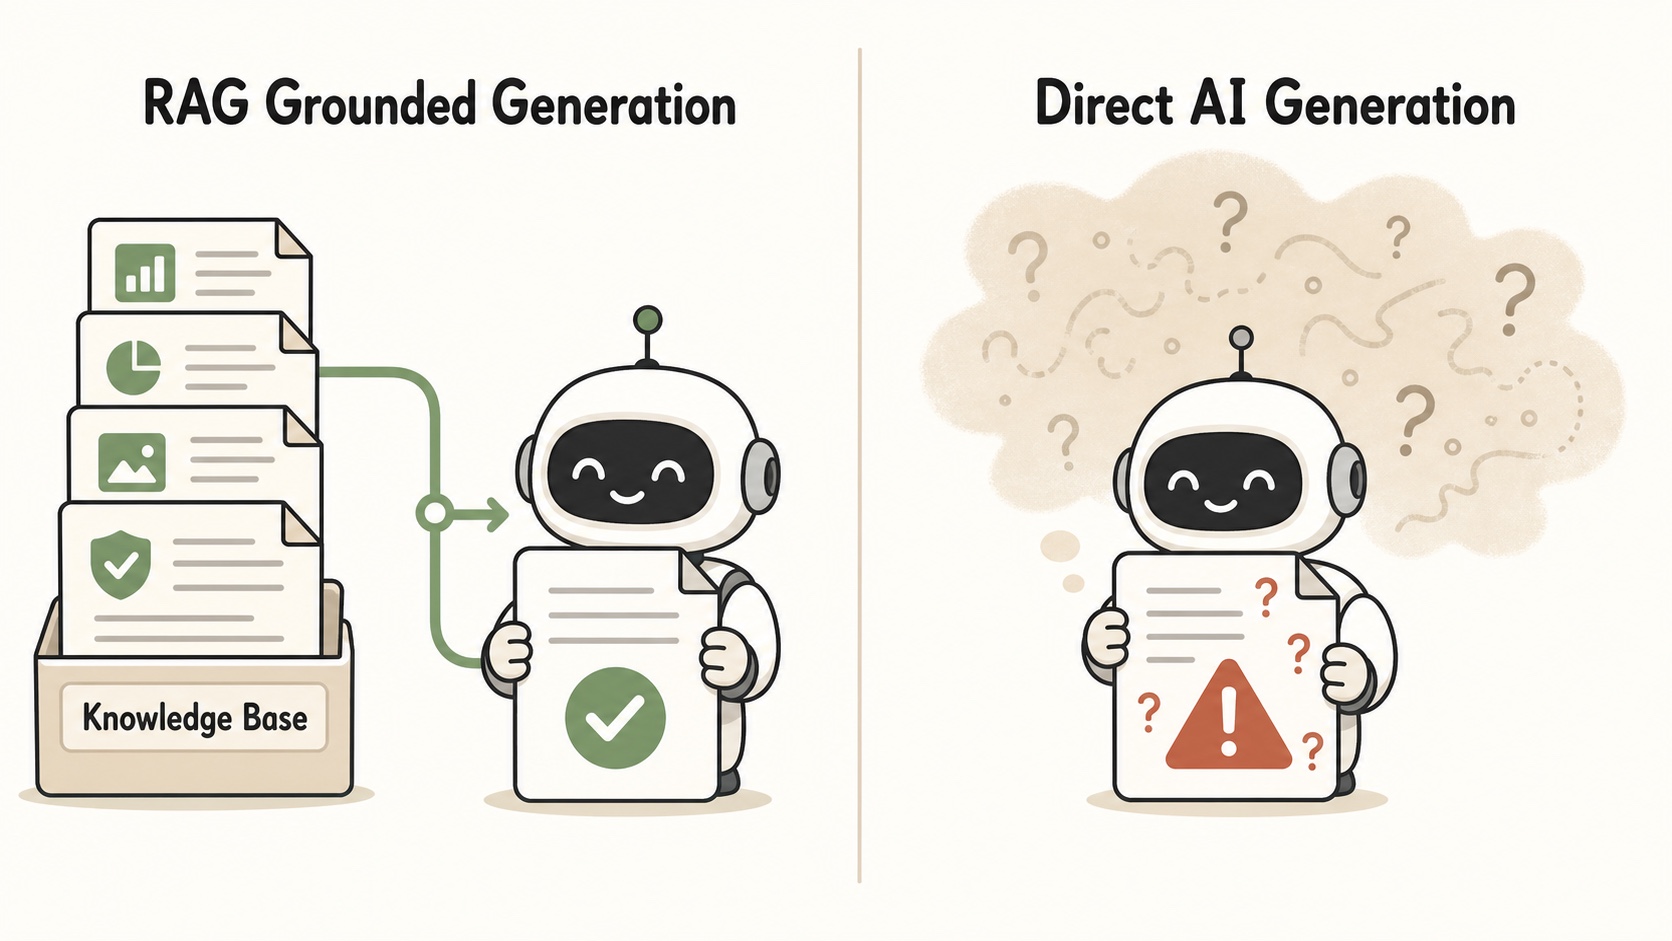
また、RAGは唯一の選択肢ではありません。複数のステップにまたがる複雑な推論業務においては、AIエージェント設計も有効です。エージェントは、計画を立て、自らデータベースやAPIを呼び出して最新の情報を取得しながらステップを踏んで処理を進めます。参照するデータを手元に引き寄せてから処理するため、ハルシネーションの確率を低く抑えることができます。ただし、得られたデータを読み解き要約する推論ステップそのものでAIが推論ミスをする可能性は残るため、プロセス設計における注意は必要です。いずれのアプローチにおいても、最も重要な設計思想は「AIを巨大な百科事典として使うのではなく、自社が提供した資料を読み解く『優秀な頭脳』として使う」という点にあります。
ワークフローによる解決:AI同士に議論させる
ハルシネーションを完全になくすことは困難ですが、人間が最終確認を行う前に、文章の表現や細かな矛盾を自動で修正する仕組みが必要です。
人間が自分の書いた文章のミスを見落としがちであるのと同様に、一つのAIモデルに自らの回答を検証させても、同じ推論ロジックの罠にはまっているため間違いに気づきません。
そこで有効なのが、異なる役割を持つ複数のモデルによる「クロスモデル・レビュー」ワークフローです。
- まず、一つのモデルが指示されたデータに基づいて下書きを作ります。
- 次に、設計や特徴が異なる別のAIモデルが、評価者としてその下書きを厳格なチェックリスト(トンマナ、禁止ワード、論理の飛躍など)に照らし合わせて検証します。
- 評価者モデルは、基準を満たしていない場合は理由を添えて元のモデルに修正を差し戻し、これを何度か繰り返します。
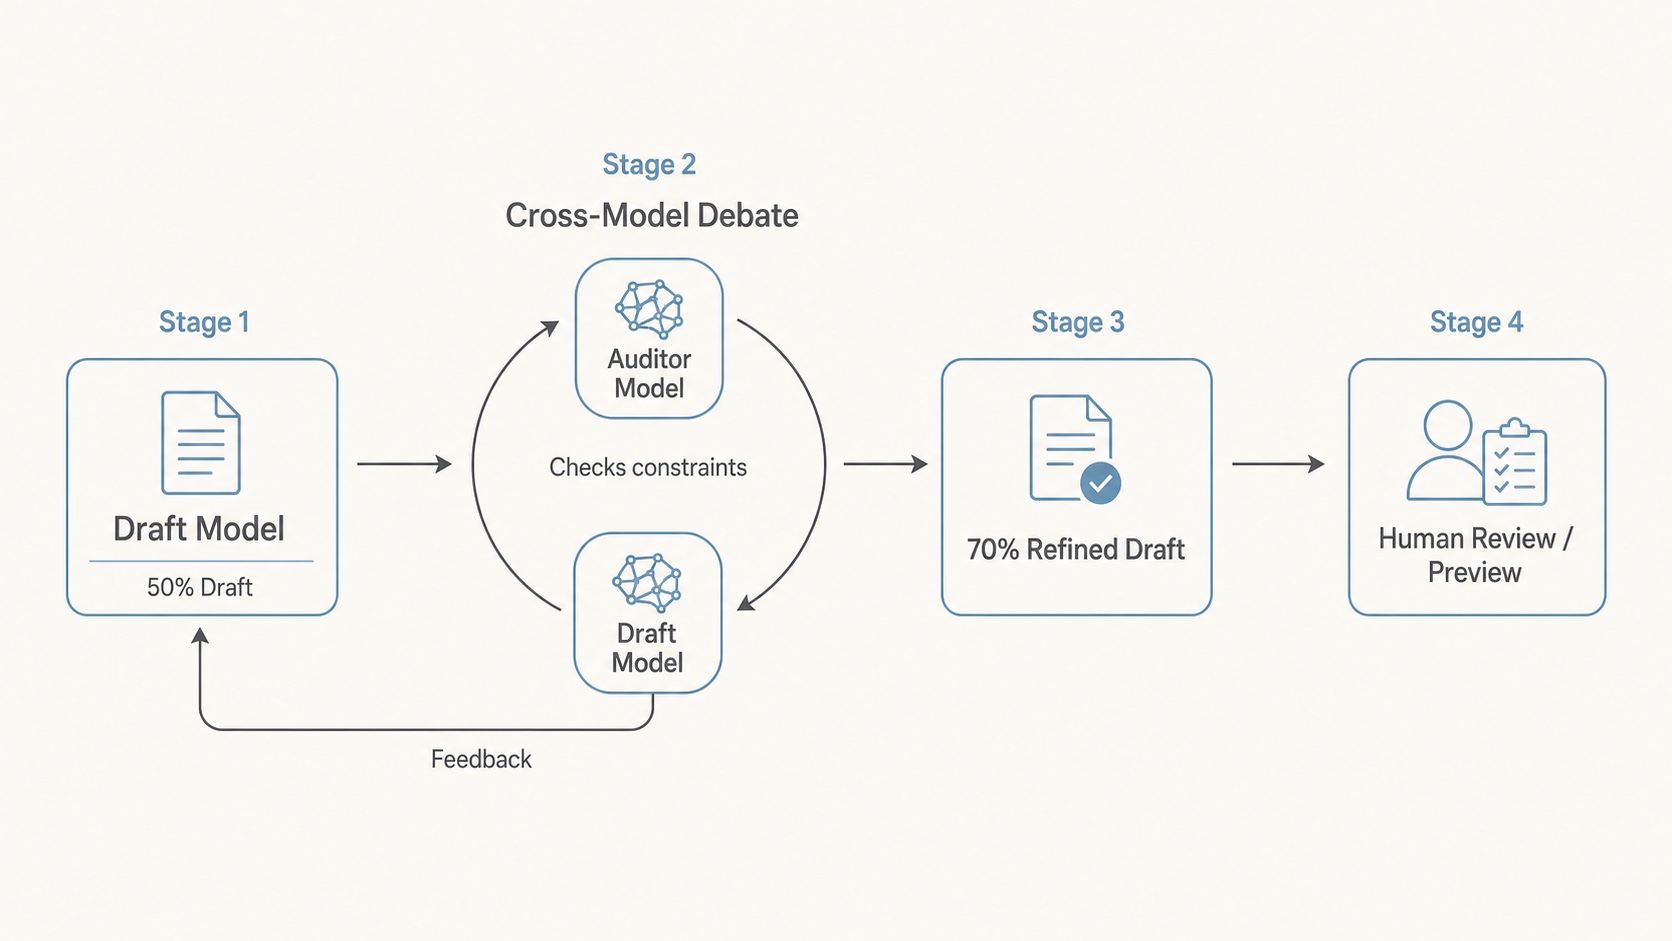
このAI同士の議論と修正のプロセスにより、最初は50%の完成度だった下書きが、人間が確認する前段階で70%以上の完成度まで引き上げられます。最終的に人間のマネジメント層に届くときには、明らかなハルシネーションや不自然な日本語表記、体裁の崩れはすでに排除されています。人が目視で確認し承認するステップは依然として必要ですが、ゼロから赤字を入れる必要はなくなり、完成間近のクオリティの高い下書きをチェックするだけで済むようになります。
この「複数AIによる相互レビュー」の仕組みをプログラミングなしで日常業務に取り入れる手順については、解説ガイド「[[AI-Skill] マルチブレインAIレビューで最高品質のアウトプットを作成する方法](https://aruo.tech/blog/260720-ai-skill-cross-ai-review)」をご覧ください。非エンジニアの方でも /cross-ai-review スキルを活用して、報告書や提案書の事前チェックを自動化する方法を具体的に解説しています。
私たちが今すぐ取り組むべきアクション
ハルシネーションは、次のモデルにアップデートされれば自然と消え去るような単純なバグではありません。言語モデルという技術の仕組み上、常に発生する可能性がある基本的な性質です。最新のモデルでもハルシネーション率はゼロにはなっておらず、実務レベルでの検証が必要です。
この性質を踏まえ、企業はすぐに以下の体制を整えるべきです。
- AIの出力は「常に未完成の下書き」として扱い、必ず人間が確認するプロセスを組み込んでください。優秀だが嘘をつくインターンのレポートを、確認せずにクライアントへ送ることはないはずです。
- ハルシネーションが発生した際のリスク(コスト)を評価し、ユースケースを分類してください。契約書確認や財務データの処理、対外的な情報発信など、間違いの許されない領域では自社データへの紐付け(RAG)と人間の目視確認が必須です。
- AIツールを導入する前に、まずは自社のデータ整理を進めてください。RAGの精度は、検索してくる社内データの整理状況に完全に依存します。整理されていない社内データからは誤った情報しか引き出せず、ハルシネーションをさらに悪化させることになります。
- 開発の初期段階から検証プロセスをワークフローに組み込んでください。AIを魔法のツールとしてではなく、特定の失敗モードを持つ道具として扱う企業だけが、実務で安定した成果を出しています。
AIを疑うのではなく、AIがどう失敗するのかを正確に把握した上で、その失敗が実害を出さないような「仕組み」を設計することが求められています。
インターンの力を引き出すために
冒頭のインターンの話に戻りましょう。問題はインターン自身にあるわけではありません。準備なしに実務を丸投げしたり、参照すべき資料を与えずに勘で書かせたりする「ワークフローの設計」に問題があります。
適切な資料を手渡し、AI同士で相互検証を行わせ、最後の確認をプロが行う。この体制さえ整えれば、かつてないスピードで業務が進み始めます。
ボトルネックはAIの知能ではなく、それを取り囲むシステムの設計です。