エグゼクティブサマリー:AIの思考を支える「デスクの広さ」という比喩
多くの企業で進められるAIの実証実験(PoC)において、複雑な文書や長文の処理精度に悩まされるケースは少なくありません。その根本的な原因は、AIモデル自体の知能不足だけではなく、大規模言語モデル(LLM)の作業記憶に相当する「コンテキストウィンドウ」の制限にあることがよくあります。
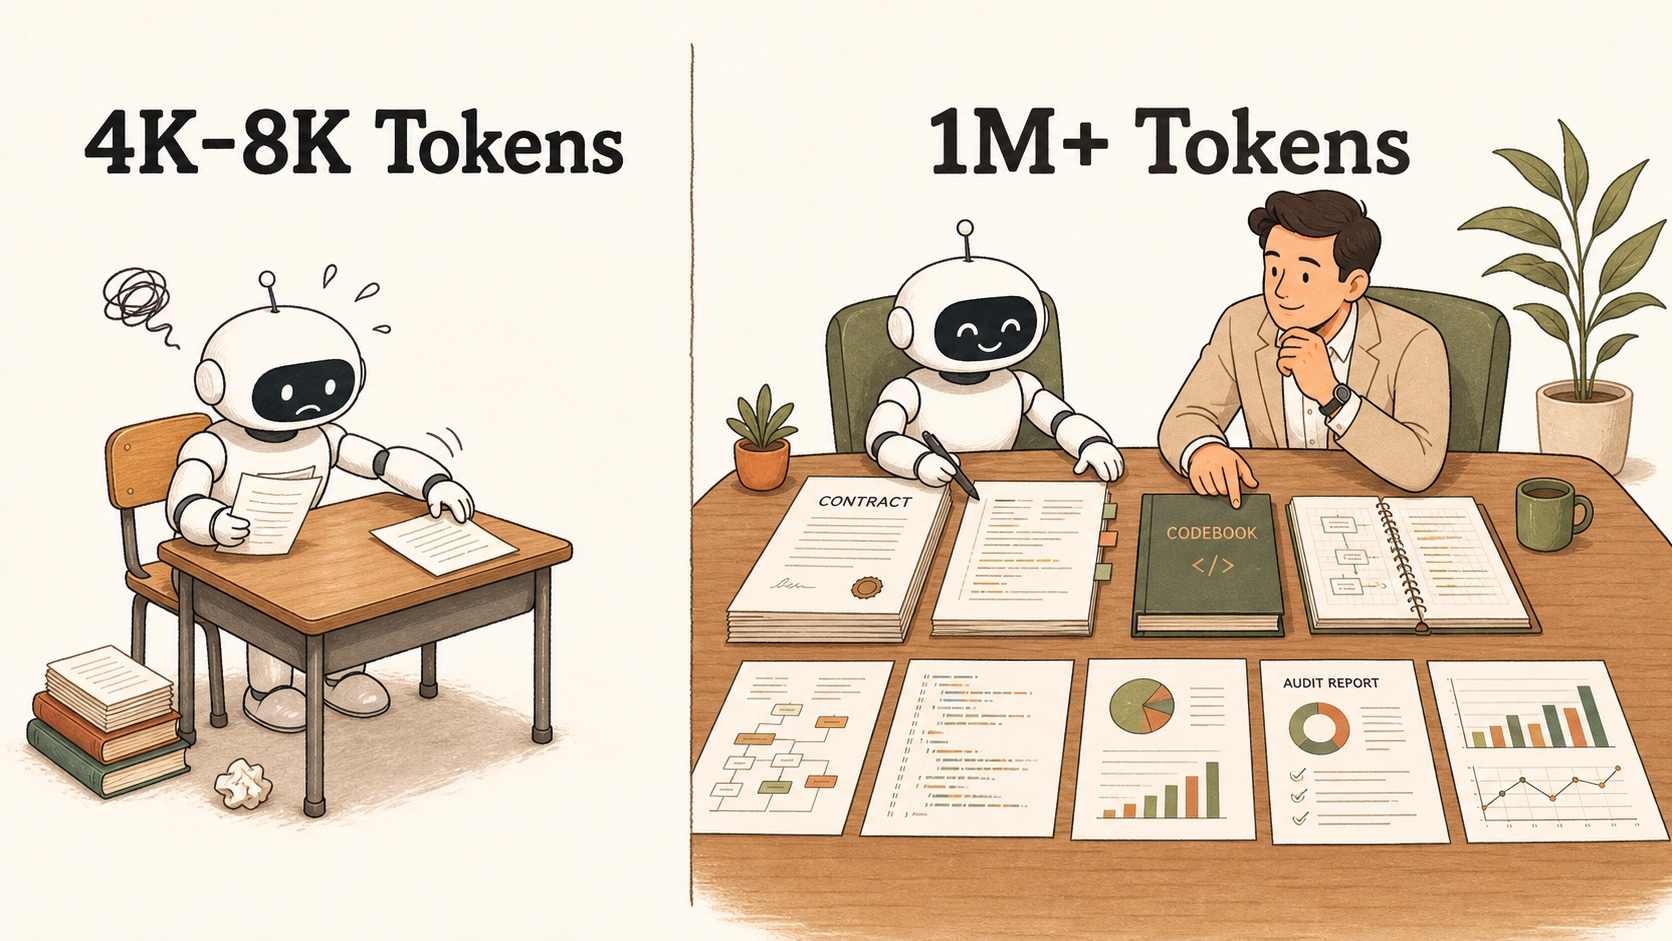
コンテキストウィンドウの仕組みを理解するには、役員の「執務デスクの広さ」を想像するのがわかりやすいでしょう。
- 小さなコンテキストウィンドウ(4,000〜8,000トークン)は、小さな学習机のようなものです。一度に短めのメモ1枚しか置けません。300ページの業務マニュアルを分析しようとすると、頻繁にページを差し替えなければならず、前後の文脈を見失うリスクが高まります。
- 巨大なコンテキストウィンドウ(100万トークン規模に対応したGoogle Geminiをはじめとする最新のフロンティアモデルなど)は、広大な会議テーブルのようなものです。数十冊に及ぶ決算書、ソースコード、契約書を横いっぱいに広げ、一目で比較参照しながら分析を行えます。
このメカニズムを正しく把握することで、経営層は自社のデジタルトランスフォーメーション(DX)推進において、最適なシステム構成を判断できるようになります。
コンテキストウィンドウとは何か?トークンはどう計算されるのか?
企業向けAIシステムを評価する際、経営陣が押さえておくべき基本概念が2つあります。
- トークン:大規模言語モデル(LLM)がデータを処理する最小単位です。英語では1トークンが約4文字(または0.75単語)に相当します。一方、日本語ではモデルや文脈によって異なり、1文字が1〜2トークン以上としてカウントされることもあります。
- コンテキストウィンドウ:1回のやり取りでモデルが一度に処理できる最大トークン数です。これには、入力プロンプト、添付ファイル、会話の履歴、そして生成される出力回答のすべてが含まれます。
入力データがコンテキストウィンドウの容量を超えると、システムの設計に応じて過去の情報が切り捨てられたり、圧縮されたりします。自動化された業務フローにおいて、この容量切れが生じると、重要な契約条件やセキュリティ規約、顧客からの個別要件が見落とされる原因になります。
なぜデスクの広さが企業DXの投資対効果(ROI)を左右するのか
単純なチャット利用から本格的な業務フローへの展開において、多くのAIプロジェクトが壁にぶつかります。コンテキストウィンドウの容量は、企業のDXを左右する3つの重要能力に直結しています。
- 複数文書の横断的統合分析 コンテキストウィンドウが狭いと、文書を細かく分割して処理せざるを得ません。十分な容量があれば、数年分の法務契約書と改定されたコンプライアンス規程を同時に読み込み、条項間の矛盾を一度に見つけ出せます。
- コードモジュールとログの一括検証 IT運用やソフトウェア開発におけるレガシーシステムの刷新では、膨大なコードの解読が必要です。広大なコンテキストウィンドウがあれば、主要なコードモジュールやシステムログを丸ごと読み込ませ、依存関係を瞬時に解析できます。
- 文脈を維持した長時間の連続対話 複雑なカスタマーサポートや多段階のデータ分析では、狭いコンテキストウィンドウだと初期の指示を見失いがちです。大きなコンテキストウィンドウは長時間の対話履歴をそのまま保持し、最初の制約条件を守りながら処理を継続できます。
技術的視点:巨大コンテキストウィンドウ vs. RAG(検索拡張生成)
経営層によくある誤解として、「100万トークンのコンテキストがあれば、社内データベースやRAG(検索拡張生成)は不要になるのではないか」という疑問が挙げられます。結論から言えば、巨大コンテキストウィンドウとRAGは、互いを補完する異なる役割を持っています。
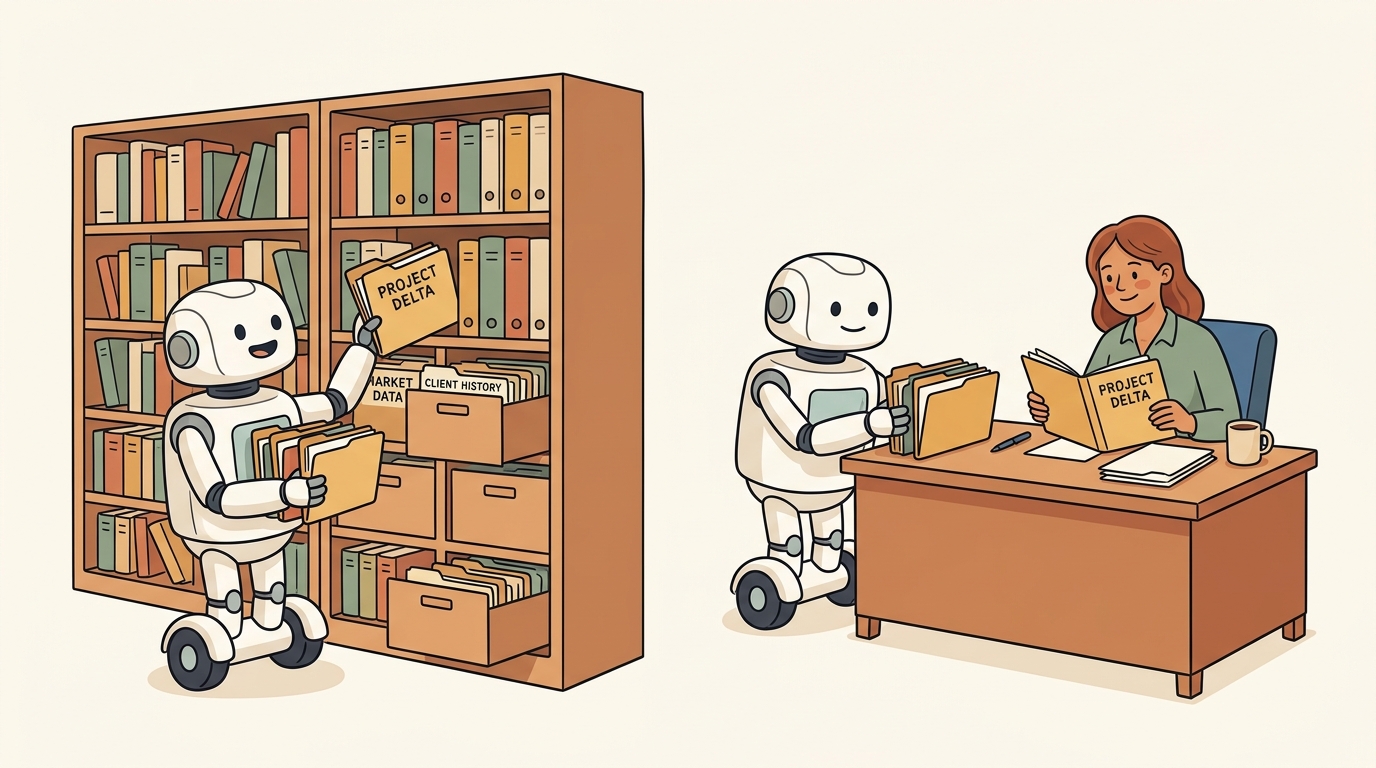
- 作業デスク vs. 書庫(ファイルキャビネット)
- コンテキストウィンドウ(作業デスク)は、現在進行形で集中分析すべき特定の書類一式を広げて深い思考を行う場です。
- RAG(書庫)は、社内にある数十万点もの文書から、いま必要な5点だけを瞬時に検索してデスクに持ち込む仕組みです。
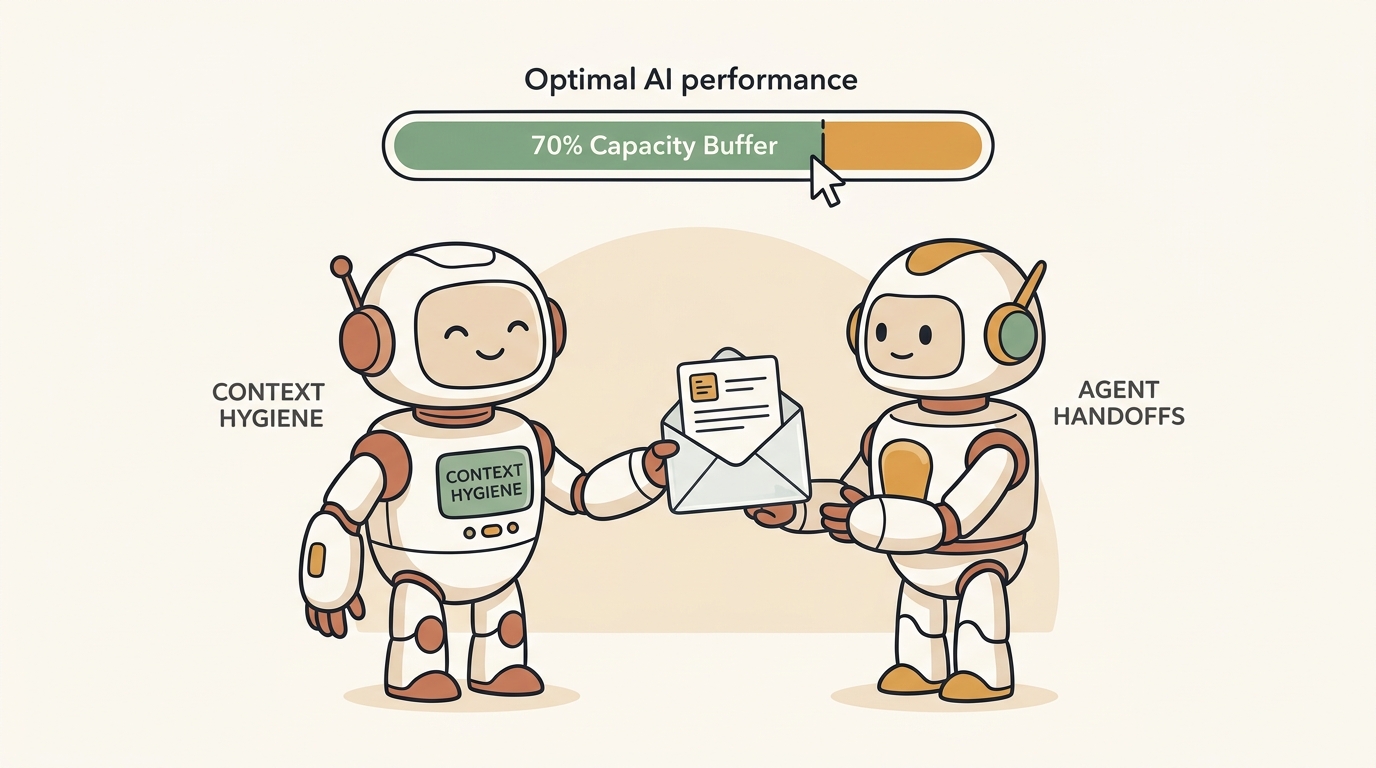
- コンテキスト容量の運用管理 どれだけ大きなデスクであっても、天板いっぱいに書類を積み上げると作業効率は落ちます。実際の運用では、モデルの応答精度を安定させるため、実効利用率を最大容量の70%程度までに抑える設計が推奨されます。限界まで詰め込むと、注目度の分散や応答速度の低下が起きやすくなるためです。
- 文脈管理の運用設計(ハンドオフとコンパクション) 長時間の連続タスクでAIの精度を高く保つには、適切な文脈管理が欠かせません。専門化されたエージェント間で整理された引き継ぎ書(ドシエ)を渡す構造化ハンドオフ・ピックアップ(Handoff & Pickup)手法や、定期的に会話履歴を要約する「コンパクション」を導入することで、常にクリアな状態を維持できます。
- 「干し草のなかの針」問題(検索精度の低下) 100万トークンを読み込めるからといって、すべての情報を完璧に記憶できるわけではありません。AIの注意機構(Attention)の特性上、長文の中央付近にある情報は見落としやすくなる現象(位置バイアス)が存在します。
- コストと処理速度のバランス 毎回100万トークンものデータを送信すると、通信コストと応答の待ち時間が増加します。実務では、RAGで必要な情報を絞り込んでから、大きなデスクの上に広げて統合分析させる構成が最も効率的です。
実践的DX戦略:業務に合わせたデスクサイズの選び方
企業のリーダーは、自社の業務複雑度に応じて適切なコンテキストサイズを選択する必要があります。
- 定型的な日常業務(標準デスク:8,000〜32,000トークン) メールの文面作成、一時的な問い合わせへの回答、短文の要約に適しています。
- 複雑な部門業務(中型デスク:128,000トークン) 中規模な報告書の分析、四半期ごとの財務データの処理、技術ドキュメントの解読に対応できます。
- 全社的なシステム刷新(巨大デスク:100万トークン以上) 全体的な文書監査、複雑な法務リスク評価、大規模なレガシーコードの書き換えに不可欠です。
自社の業務要件に合わせてコンテキスト容量、安全マージン、そしてRAGなどの検索基盤を最適に組み合わせることで、コストを抑えつつ最大の投資対効果(ROI)を実現できます。